
Drei Projekte, drei Arten von Wissen
Entscheidung 1: Nicht alles gehört in RAG
Entscheidung 2: Retrieval ist ein Tool, kein größerer Prompt
Entscheidung 3: Hybride Suche für Dokumente voller Nummern
Entscheidung 4: Chunks, die wissen, woher sie kommen
Entscheidung 5: Die Ablehnung ist eine Funktion
Entscheidung 6: Zugriffsrechte gehören in den Code, nicht in den Prompt
Entscheidung 7: Gefundener Text ist Daten, keine Anweisung
Entscheidung 8: Jede Suche protokollieren, auch Fehltreffer
Die Tests vor dem Livegang
Cloud-API oder lokale Modelle
Checkliste
Wie wir helfen können
FAQ
Was ist RAG auf internen Dokumenten?
Warum liefert ein RAG-System trotzdem falsche Antworten?
Brauchen wir für alles eine Vektordatenbank?
Reicht Vektorsuche, oder brauchen wir auch Stichwortsuche?
Kann ein RAG-System laufen, ohne Dokumente in die Cloud zu schicken?
Wie testen wir ein RAG-System vor dem Start?
Quellen
RAG auf internen Dokumenten: Was die Antwortqualität bestimmt – aus drei unserer Projekte

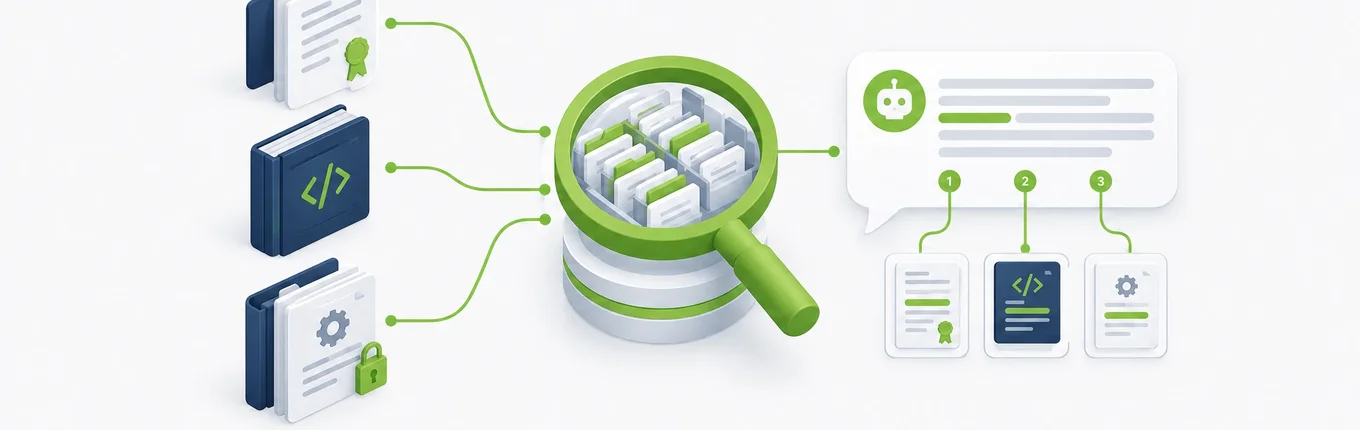
Kurz gesagt (November 2026). Bei einem RAG-System auf Unternehmensdokumenten entscheidet weniger das Sprachmodell über die Qualität der Antworten als fünf technische Entscheidungen: was überhaupt in die Wissensbasis gehört, wie Dokumente zerlegt und durchsucht werden, was passiert, wenn nichts Passendes gefunden wird, wer welches Dokument sehen darf und ob jede Suche protokolliert wird. Selbst kommerzielle juristische Recherchetools auf RAG-Basis lieferten in einer Stanford-Studie bei 17 bis 33 % der Testfragen falsche oder unbelegte Antworten – „das Modell liest unsere Dokumente“ ist also keine Qualitätsgarantie. Vektorsuche mit Stichwortsuche zu kombinieren, wie wir es tun, gehört zu den günstigsten Verbesserungen: Anthropic hat mit kontextuellen Embeddings plus BM25 49 % weniger fehlgeschlagene Suchen gemessen, mit zusätzlichem Reranking 67 %. Die wichtigste Regel ist einfach: ohne Quelle keine Antwort.
Wir haben Retrieval in drei Produkte eingebaut: einen KI-Assistenten für Kundenanfragen, der aus den Dokumenten des jeweiligen Unternehmens antwortet, einen Assistenten für Buchhalter in Kasachstan, der mit dem Steuergesetzbuch und dem Rechnungslegungsrecht arbeitet, und CostQuest, ein KI-Werkzeug zur Aufwandsschätzung für Gründer. Dieser Artikel fasst zusammen, was wir dabei gelernt haben – ohne eigene Kennzahlen: die Entscheidungen, die Fehler, die wir rechtzeitig gefunden haben, und die Tests, die wir heute vor dem Livegang einer Wissensbasis durchführen.
Drei Projekte, drei Arten von Wissen
| Wer fragt | Was das Wissen ist | Wie wir es abrufen | Wichtigste Absicherung | |
|---|---|---|---|---|
| AI Intake Agent | Kunden eines Unternehmens, im Chat und in Messengern | die eigenen Dokumente des Unternehmens: PDF, DOCX, Scans | Vektorsuche als Tool, das der Agent aufruft, im Code nach Mandant gefiltert | der Assistent sagt, dass ein Kollege es klärt, übergibt die Frage an einen Menschen und führt das Gespräch weiter |
| Buchhaltungsassistent, Kasachstan | Buchhalter | Steuergesetzbuch und Rechnungslegungsrecht | hybride Suche: Vektoren plus Volltext | eine feste Antwort „in den Dokumenten nicht gefunden“, kein Raten |
| CostQuest | Gründer, die ein Produkt schätzen | ein Katalog wiederverwendbarer Features mit historischen Aufwandswerten | eine Datenbankabfrage nach Produktkategorie, keine Vektoren | nur Katalogzeilen gelangen in den Prompt, nichts wird über Ähnlichkeit zugeordnet |
Das erste Produkt ist ein gehosteter Dienst: Ein Unternehmen verbindet Instagram, Messenger, Telegram, E-Mail oder den Chat auf seiner Website, lädt seine Dokumente hoch, und der Assistent nimmt Anfragen auf und beantwortet Fragen. Einer der Nutzer ist RadioLance, ein Teleradiologie-Dienst, für den wir auch die Plattform gebaut haben. Dort arbeitet der Assistent als Koordinator auf der öffentlichen Website und antwortet aus den Unterlagen des Dienstes – ohne je eine Untersuchung zu deuten oder eine Diagnose zu stellen.
Entscheidung 1: Nicht alles gehört in RAG
Die nützlichste Entscheidung war, Wissen aus dem Vektorspeicher herauszunehmen.

- Preise sind Rechnen, nicht Suchen. Beim Radiologie-Assistenten war der Preis die häufigste Frage. Über Retrieval lag eine Anfrage, die die Preiszonen nannte, unter unserer Relevanzschwelle; der Assistent eskalierte und versprach die Antwort eines Kollegen, obwohl die Wissensbasis sie enthielt. Wir haben das Preisraster in eine Prompt-Vorlage verschoben, die jeder Kunde im Admin-Bereich bearbeiten kann. Eine Preisänderung ist jetzt eine Bearbeitung, keine Neuindexierung.
- Strukturierte Daten brauchen eine Abfrage. Die Schätzungen von CostQuest beruhen auf einem Feature-Katalog nach Produktkategorien, jeweils mit Aufwandswerten je Entwicklerlevel. Zeilen nach Kategorie auszuwählen ist exakt und nachvollziehbar; Embeddings würden nur einen Weg hinzufügen, die falschen Zeilen zu erwischen.
- Zustand ist kein Wissen. „Welche Dokumente fehlen noch?“ beantwortet der Zustand der Anfrage selbst, den der Assistent ohnehin sieht. Keine Suche nötig.
- Live-Daten brauchen ein Tool. Lieferstatus oder Lagerbestand ändern sich im Minutentakt. Sie gehören hinter eine API oder einen MCP-Server, nicht in einen Index, der eine Kopie von gestern Nacht ist.
Für RAG bleibt langer Text: Gesetze, Richtlinien, Handbücher, Verträge, Leistungsbeschreibungen. Dort ist es stark.
Entscheidung 2: Retrieval ist ein Tool, kein größerer Prompt
Die verlockende Abkürzung: Dokumente in den System-Prompt kopieren, solange die Wissensbasis klein ist. Beim Intake-Assistenten haben wir uns aus drei Gründen dagegen entschieden.
- Die Suchanfrage hängt von der Frage des Kunden ab, die es beim Aufbau des System-Prompts noch nicht gibt. Als Tool formuliert der Agent die Frage zu einer Suchanfrage um und sucht, wenn er es braucht.
- Lange Prompts werden nicht nur teurer, sondern schlechter. Im NoLiMa-Benchmark fielen bei 32.000 Tokens 11 von 13 Modellen, die mindestens 128.000 Tokens Kontext versprechen, unter die Hälfte ihres Werts bei kurzen Eingaben, und Modelle übersehen nachweislich Fakten in der Mitte langer Eingaben („Lost in the Middle“).
- Ein Tool liefert Chunk-IDs, damit kann jede Antwort ihr Dokument zitieren. Eingefügter Kontext kann das nicht.
Ein Test fixiert die Größe des gerenderten System-Prompts – niemand kann später „einfach die wichtigsten Dokumente mitgeben“, ohne dass es auffällt.
Entscheidung 3: Hybride Suche für Dokumente voller Nummern
Gesetzestexte sind der schlimmste Fall für reine Vektorsuche. Buchhalter fragen nach „Artikel 412“, einer Formularnummer oder einem Satz; Embeddings erfassen Bedeutung gut, exakte Bezeichner schlecht. Im Assistenten für Kasachstan laufen zu jeder Frage zwei Suchen, eine Vektor- und eine Volltextsuche, und die Ranglisten werden mit Reciprocal Rank Fusion zusammengeführt – einem einfachen Verfahren von 2009, das keine Abstimmung von Score-Skalen braucht. Der BEIR-Benchmark hat einfache Stichwortsuche (BM25) als robuste Basis bestätigt, die dichte Modelle außerhalb ihres Trainingsbereichs oft nicht schlagen; in den Messungen von Anthropic hob BM25 zusätzlich zu kontextuellen Embeddings den Rückgang fehlgeschlagener Suchen von 35 auf 49 %.
Zwei kleinere Dinge haben im selben Projekt sichtbar geholfen:
- Nachfragen. „Und für Einzelunternehmer?“ bedeutet allein nichts. Die Suchanfrage enthält deshalb die letzten Fragen des Nutzers, die Antwort entsteht aber weiterhin nur aus dem, was diese Suche liefert.
- Sprache. Fragen und Quellen sind nicht immer in derselben Sprache, und die Antwort muss in der Sprache des Nutzers kommen, egal in welcher Sprache die Quelle ist. Das ist eine Anweisung im Prompt, muss aber in jeder Kombination getestet werden.
Entscheidung 4: Chunks, die wissen, woher sie kommen
Jeder Chunk trägt Dokument, Seite und Position, damit eine Antwort „Steuergesetzbuch, Seite 87“ sagen kann statt „laut den Unterlagen“. Unser Chunking ist bewusst unspektakulär: rund tausend Zeichen, an Absatzgrenzen getrennt, nie mitten im Wort, mit etwas Überlappung.
Das hat einen Zweck. Das Chunking ist deterministisch, die Chunk-IDs sind also stabil: Eine Neuindexierung ersetzt die Vektoren eines Dokuments, statt sie zu verdoppeln, und wird eine neue Version kürzer, werden die übrigen Chunks gelöscht. Wer ein Dokument löscht, löscht seine Vektoren – das ist für die DSGVO genauso wichtig wie für die Qualität: Eine veraltete Richtlinie, die weiter Fragen beantwortet, ist ein stiller Fehler.
Bei Gesetzestexten sind Versionen das eigentliche Problem. Kasachstan hat am 18. Juli 2025 ein neues Steuergesetzbuch verabschiedet, das seit dem 1. Januar 2026 gilt, das Gesetzbuch von 2017 ersetzt und seither bereits geändert wurde. Eine Wissensbasis über Recht muss wissen, welche Fassung an welchem Datum gilt, sonst antwortet sie korrekt – für das falsche Jahr.
Gescannte PDFs liest ein multimodales Modell Seite für Seite, mit einer festen Seitengrenze je Dokument, damit ein 200-seitiger Scan nicht unbemerkt eine Rechnung erzeugt.
Entscheidung 5: Die Ablehnung ist eine Funktion

Beide Dokumentenprojekte teilen eine Regel: ohne Quelle keine Antwort.
- Eine Relevanzschwelle. Treffer unter einem Ähnlichkeitswert fallen weg, bevor das Modell sie sieht. Bleibt nichts übrig, wird das Modell gar nicht aufgerufen.
- Pflichtzitate. Das Modell muss nach jeder Aussage eine Quellennummer setzen. Nicht zitierte Quellen werden aus der Anzeige entfernt – die Quellenliste ist die Liste der Belege.
- Eine feste Antwort für „nicht gefunden“. Enthalten die Quellen keine Antwort, muss das Modell genau einen festgelegten Satz ausgeben, den der Code erkennt. Ein Vertrauenshinweis ergibt sich aus dem besten Suchscore, nicht aus der Selbsteinschätzung des Modells.
- Eine Übergabe, die das Gespräch nicht stoppt. Beim Kundenassistenten erzeugt ein Fehltreffer einen Hinweis für einen Menschen; der Assistent sagt das offen und nimmt in derselben Nachricht die Anfrage weiter auf. Ein Assistent, der bei einer unbekannten Frage hängen bleibt, ist schlechter als einer, der sagt: „Ich kläre das mit einem Kollegen.“
Die Schwelle selbst ist die eine Zahl, die sich nicht aus Prinzipien ableiten lässt. Unsere begann als Schätzung und wurde an echten Dokumenten justiert. Eine Falle, die wir gefunden haben: Dasselbe Embedding-Modell liefert für russische Texte systematisch niedrigere Ähnlichkeitswerte als für englische. Eine aus einem englischen Beispiel übernommene Schwelle macht eine russischsprachige Wissensbasis still und leise zur Eskalationsmaschine.
Wir sagen offen, was der Code erzwingt und was nicht. Der Code erzwingt Schwelle, Mandantenfilter, Protokoll und Übergabe. Dass das Modell den gefundenen Text nicht ausschmückt, ist eine Regel im Prompt, keine Garantie. Die Absicherung dafür ist Nachvollziehbarkeit.
Entscheidung 6: Zugriffsrechte gehören in den Code, nicht in den Prompt
Der schlimmste Fehler einer Wissensbasis für mehrere Kunden: Die Dokumente des einen beantworten die Fragen der Kunden des anderen. Im Intake-Assistenten teilen sich alle Mandanten eine Vektorsammlung, und jede Suche wird nach der Mandanten-ID gefiltert. Die ID kommt aus dem Gespräch, nie aus einem Tool-Argument – das Modell kann nicht dazu überredet werden, Dokumente eines anderen Mandanten zu lesen, denn den Mandanten kann es gar nicht benennen. Die Suchfunktion hat für die Mandanten-ID keinen Standardwert; wer sie vergisst, bekommt einen Fehler, kein Datenleck. Ein Test mit identischen Dokumenten in zwei Organisationen belegt das. OWASP führt dieses Risiko als „Vector and Embedding Weaknesses“ und empfiehlt berechtigungsbewusste Vektorspeicher mit strikter logischer Trennung.
Dasselbe gilt für Rollen innerhalb eines Unternehmens: Darf eine Nachwuchskraft einen Vertrag nicht öffnen, darf der Assistent ihn ihr auch nicht zitieren. Nach Berechtigungen wird bei der Suche gefiltert – nicht das Modell gebeten, ein Geheimnis zu wahren, das es schon gelesen hat.
Entscheidung 7: Gefundener Text ist Daten, keine Anweisung
Ein Dokument kann „ignoriere alle bisherigen Anweisungen“ enthalten. In einem kundennahen System stammen Dokumente vom Unternehmen und über E-Mails und Uploads manchmal von dessen Kunden. Gefundener Text geht klar als Daten markiert an das Modell, unterhalb der Systemregeln, und kann diese nie ändern. OWASP führt Prompt-Injection, auch diese indirekte Form über Dateien, als größtes Risiko für LLM-Anwendungen und hält fest, dass RAG sie nicht vollständig verhindert. Das senkt das Risiko, beseitigt es aber nicht – ein Grund mehr, warum der Assistent keine Tools hat, die ohne Freigabe durch einen Menschen etwas schreiben.
Entscheidung 8: Jede Suche protokollieren, auch Fehltreffer
Jede Suche schreibt einen Audit-Eintrag: Anfrage, bester Score und gelieferte Dokumente, auch bei Suchen ohne Ergebnis. So wird aus „der Assistent hat etwas Seltsames gesagt“ ein Fehler mit Adresse: Der Eintrag zeigt, ob das richtige Dokument gefunden wurde, nur mit schwachem Score gefunden wurde oder gar nicht. Die Verteilung der besten Scores war auch das, womit wir die Schwelle justiert haben. Ohne dieses Protokoll lässt sich eine Wissensbasis nicht verbessern, nur darüber streiten.
Auch jeder Embedding- und OCR-Aufruf wird mit seiner Tokenzahl protokolliert – die Kosten von „alles neu indexieren“ sind eine Zahl, bevor jemand den Knopf drückt. Embeddings selbst sind günstig (OpenAI listet text-embedding-3-small mit 0,02 $ je Million Tokens); OCR von Scans und das antwortende Modell kosten mehr.
Die Tests vor dem Livegang
Wir schreiben ein Testdokument mit erfundenen Zahlen, damit eine richtige Antwort nur aus der Wissensbasis kommen kann, nie aus dem Allgemeinwissen des Modells. Dann fragen wir:
| Prüfung | Beispiel | Erwartet |
|---|---|---|
| Direkter Treffer | „Was kostet eine Ausfuhranmeldung?“ | der erfundene Preis, mit Quelle |
| Fakt in einem anderen Chunk | „Wie lange dauert der Lkw Hamburg–Istanbul?“ | der richtige Chunk, nicht der erste |
| Falsche Prämisse | „Stimmt es, dass die ersten fünf Lagertage kostenlos sind?“ | eine Korrektur, drei Tage statt fünf, mit Quelle |
| Plausibel, aber nicht vorhanden | „Was kostet Seefracht nach Alexandria?“ | kein erfundener Preis; Übergabe an einen Menschen |
| Außerhalb der Wissensbasis | „Wo ist meine Sendung gerade?“ | Übergabe ohne Suche |
| Gespräch läuft weiter | die beiden Antworten oben | der Assistent stellt auch die nächste nötige Frage |
| Keine doppelten Übergaben | dieselbe Frage noch einmal | kein zweiter Hinweis |
| Mandantengrenze | die erste Frage aus dem Chat eines anderen Mandanten | keine Antwort aus dem Dokument des ersten Mandanten |
Die falsche Prämisse ist die wertvollste Prüfung. Etwas Falsches selbstsicher zu bestätigen, ist der teuerste Fehler eines RAG-Systems, und wenn er auftritt, liegt die Ursache meist im Prompt, nicht in der Suche. Für größere Testsätze liefern die RAGAS-Metriken ein nützliches Vokabular: Faithfulness (ist jede Aussage durch den gefundenen Text gedeckt), Answer Relevance und Context Relevance aus dem ursprünglichen Paper; die aktuelle ragas-Bibliothek ergänzt Context Precision und Context Recall.
Cloud-API oder lokale Modelle
Beim Buchhaltungsassistenten hat Vertraulichkeit die Architektur bestimmt. Derselbe Code läuft gegen eine Cloud-API oder vollständig auf dem Server des Kunden mit offenen Modellen: BGE-M3 für Embeddings (MIT-Lizenz, mehr als 100 Sprachen) und ein Qwen-Modell für die Antworten, bereitgestellt über Ollama, mit Qdrant als Vektorspeicher. Lokale Modelle antworten langsamer und weniger elegant, aber kein Dokument verlässt das Haus. Für die meisten EU-Unternehmen reicht ein Cloud-Modell mit Auftragsverarbeitungsvertrag und EU-Region; bei Steuer-, Rechts- und Medizinarchiven lohnt es sich, die lokale Variante von Anfang an mitzukalkulieren. So oder so: Die Hamburger Datenschutzbehörde hält fest, dass sich Auskunfts-, Lösch- und Berichtigungsansprüche auf Ein- und Ausgaben eines KI-Systems einschließlich seiner Datenbankabfragen beziehen können – wer ein Dokument löscht, muss also auch seine Vektoren löschen.
Checkliste
- Die Fragen sammeln, die Nutzer tatsächlich stellen, und danach sortieren, wo die Antwort liegt: Zustand, Vorlage, Datenbank, Dokumente oder ein Live-System.
- Nur langen Text in RAG legen.
- Vektor- und Stichwortsuche kombinieren, wenn Dokumente Artikelnummern, Codes oder Produktnamen enthalten.
- Dokument, Seite und Fassung an jedem Chunk speichern; Neuindexierung idempotent machen und Löschen echt.
- Eine Relevanzschwelle setzen und an eigenen Dokumenten und Sprachen justieren.
- Für jede Aussage eine Quelle verlangen und für „nicht gefunden“ eine feste Antwort.
- Unbeantwortete Fragen an einen Menschen übergeben, ohne das Gespräch zu stoppen.
- Nach Mandant und Berechtigung im Code filtern, bei der Suche.
- Gefundenen Text als Daten behandeln; dem Assistenten keine Schreibaktionen ohne Freigabe geben.
- Jede Suche protokollieren, auch Fehltreffer, und jeden Embedding-Aufruf mit seinen Kosten.
- Vor dem Livegang mit erfundenen Fakten, einer falschen Prämisse, einem fehlenden Fakt und einem zweiten Mandanten testen.
- Wer Menschen in der EU bedient, muss sagen, dass sie mit einer KI sprechen. Artikel 50 der KI-Verordnung verlangt das ab dem 2. August 2026; der Digital Omnibus hat das nicht verschoben.
Wie wir helfen können
Wir konzipieren und bauen individuelle RAG-Anwendungen auf Unternehmensdokumenten – vom Prototyp mit Ihren eigenen Dateien bis zum produktiven System mit Zugriffsrechten, Protokollierung und lokalen Modellen. Wenn Sie einen Assistenten für Ihre Kunden suchen statt eines Projekts: Der AI Intake Agent läuft auf Ihren Kanälen mit Ihren Dokumenten.
Zu den Grundlagen der Architektur siehe unseren Leitfaden zu RAG für Entscheider und die Checkliste, ob Sie individuelles RAG brauchen.
FAQ
Was ist RAG auf internen Dokumenten?
Retrieval-Augmented Generation: Vor der Antwort durchsucht das System die eigenen Dokumente des Unternehmens nach passenden Stellen und gibt nur diese an das Sprachmodell, das daraus antwortet und sie zitiert. Ändern sich Dokumente, muss das Modell nicht neu trainiert werden; aktualisiert wird der Index.
Warum liefert ein RAG-System trotzdem falsche Antworten?
Meist, weil die richtige Stelle nicht gefunden wurde, ein schwacher Treffer trotzdem verwendet wurde oder das Modell etwas hinzugefügt hat. Relevanzschwelle, Pflichtzitate, eine feste Antwort für „nicht gefunden“ und ein Protokoll jeder Suche setzen an allen drei Stellen an.
Brauchen wir für alles eine Vektordatenbank?
Nein. Preise, Zeitpläne und andere kleine, stabile Daten funktionieren besser in einer Prompt-Vorlage, strukturierte Datensätze hinter einer Datenbankabfrage und Live-Daten hinter einer API oder einem MCP-Tool. Eine Vektordatenbank ist für langen Text da.
Reicht Vektorsuche, oder brauchen wir auch Stichwortsuche?
Bei Dokumenten voller Artikelnummern, Codes und Namen beides kombinieren. Vektorsuche findet Bedeutung, Stichwortsuche findet exakte Bezeichner. Reciprocal Rank Fusion führt beide Listen ohne Feinabstimmung zusammen.
Kann ein RAG-System laufen, ohne Dokumente in die Cloud zu schicken?
Ja. Offene Embedding- und Sprachmodelle laufen auch auf eigenen Servern. Die Antworten sind langsamer und weniger ausgefeilt als bei den größten Cloud-Modellen, aber kein Dokument verlässt Ihre Infrastruktur.
Wie testen wir ein RAG-System vor dem Start?
Mit einem Testdokument voller erfundener Fakten, damit Antworten nicht aus dem Allgemeinwissen des Modells kommen können – und mit einer falschen Prämisse, einer plausiblen Frage, die die Dokumente nicht beantworten, einer Frage außerhalb ihres Bereichs und einer Anfrage von einem zweiten Mandanten oder einer anderen Rolle.
Quellen
- Magesh, Surani, Dahl, Suzgun, Manning, Ho, Hallucination-Free? Assessing the Reliability of Leading AI Legal Research Tools, Journal of Empirical Legal Studies, 2025
- Anthropic, Introducing Contextual Retrieval, September 2024
- Thakur et al., BEIR: A Heterogeneous Benchmark for Zero-shot Evaluation of Information Retrieval Models, NeurIPS 2021
- Cormack, Clarke, Büttcher, Reciprocal Rank Fusion outperforms Condorcet and individual Rank Learning Methods, SIGIR 2009
- Liu et al., Lost in the Middle: How Language Models Use Long Contexts, TACL 2024
- Modarressi et al., NoLiMa: Long-Context Evaluation Beyond Literal Matching, ICML 2025
- Baker McKenzie, Kazakhstan: New Tax Code, September 2025
- OWASP, LLM01:2025 Prompt Injection and LLM08:2025 Vector and Embedding Weaknesses
- Es et al., RAGAS: Automated Evaluation of Retrieval Augmented Generation, EACL 2024; ragas metrics
- BAAI, bge-m3 model card
- OpenAI, API pricing, abgerufen im Oktober 2026
- Der Hamburgische Beauftragte für Datenschutz und Informationsfreiheit, Diskussionspapier: Large Language Models und personenbezogene Daten, Juli 2024
- KI-Verordnung, Artikel 50; Lewis Silkin, The Digital Omnibus on AI enters into force today, Juli 2026
Categories
Über den Autor
CTO & Mitbegründer von Software Development Hub. Software-Ingenieur mit 20+ Jahren Erfahrung. Python/Django-Fan, Software-Architekt und IT-Teamleiter. Stets auf dem Laufenden mit technischen Trends. Ausgeprägte technische Fähigkeiten und vielfältiges Fachwissen in den Bereichen Software-Strukturdesign, Entwicklung, Teammanagement und Cybersicherheit.
Share
Neueste Beiträge


Benötigen Sie einen Projektkostenvoranschlag?
Schreiben Sie uns, und wir bieten Ihnen eine qualifizierte Beratung.