RAG-Assistent für Kanzleien mit seitengenauen Quellenangaben
Ein SDH-Prototyp: juristisches Backoffice mit KI-Assistent, der nur aus Aktendokumenten antwortet und die Seite nennt.
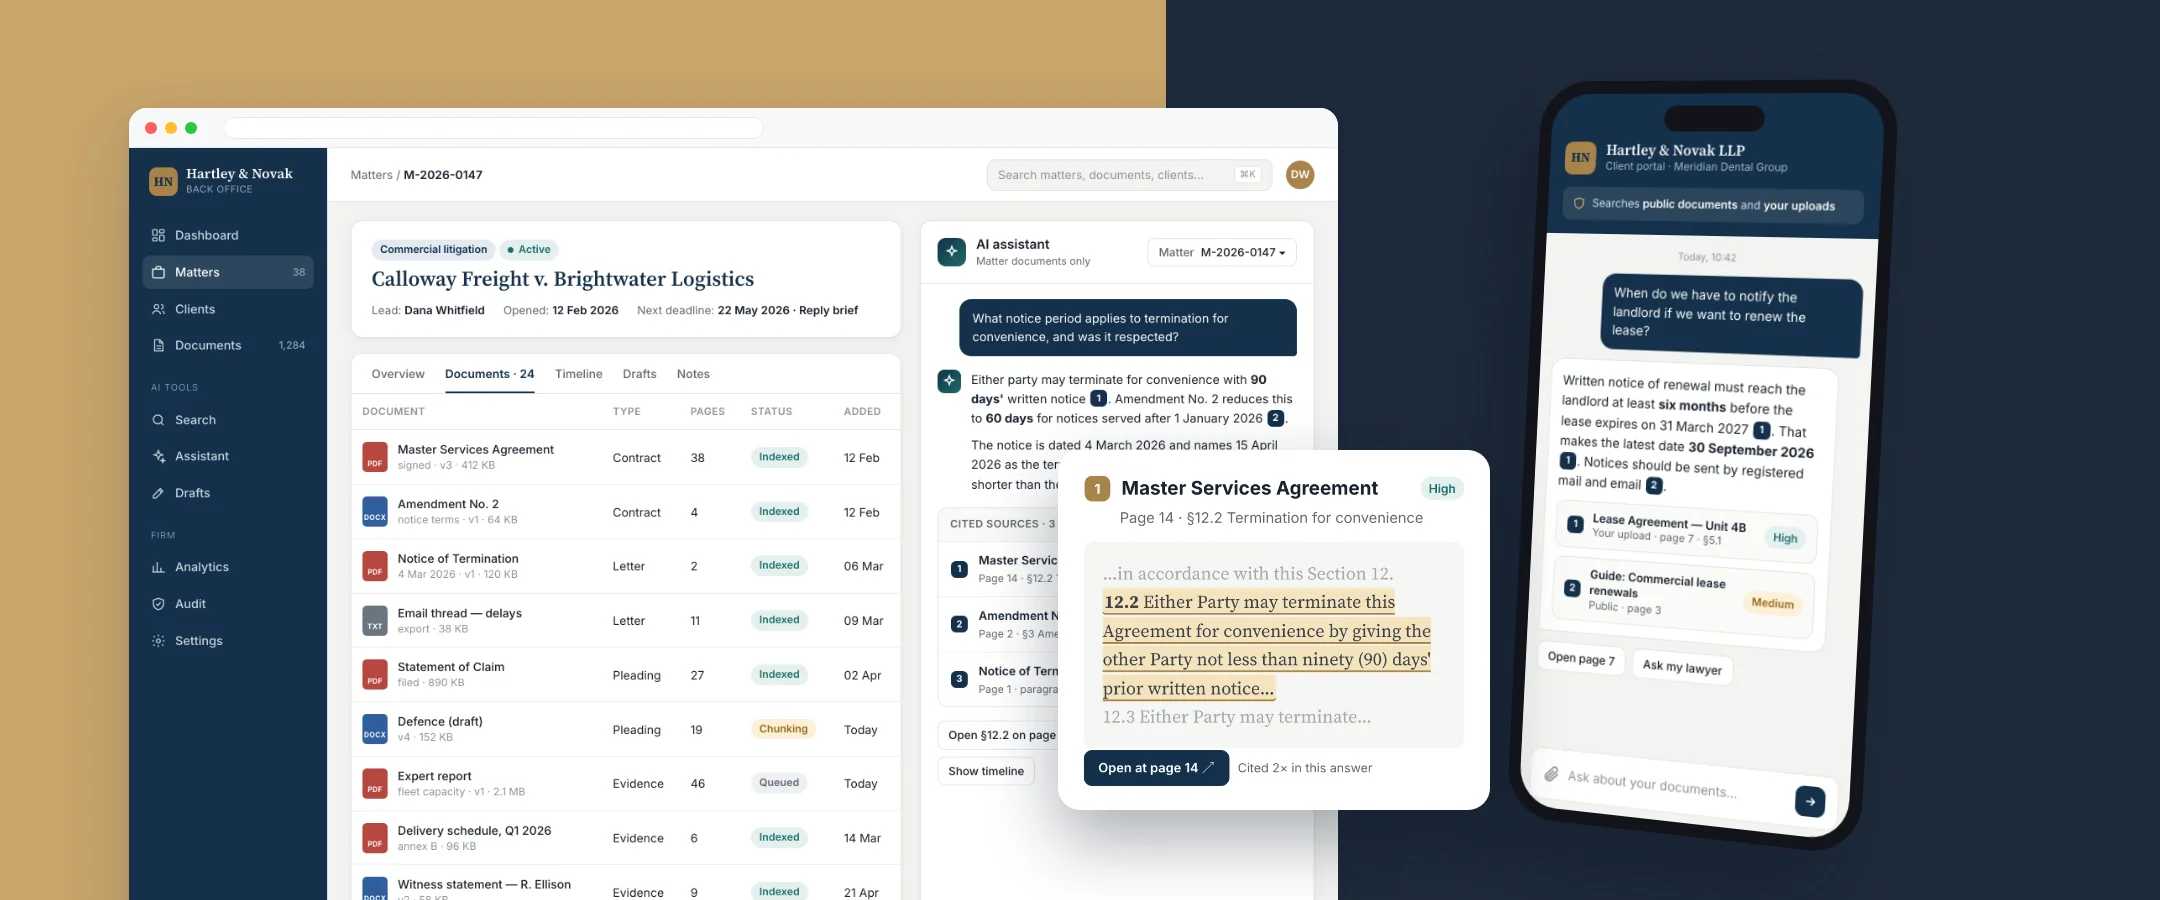
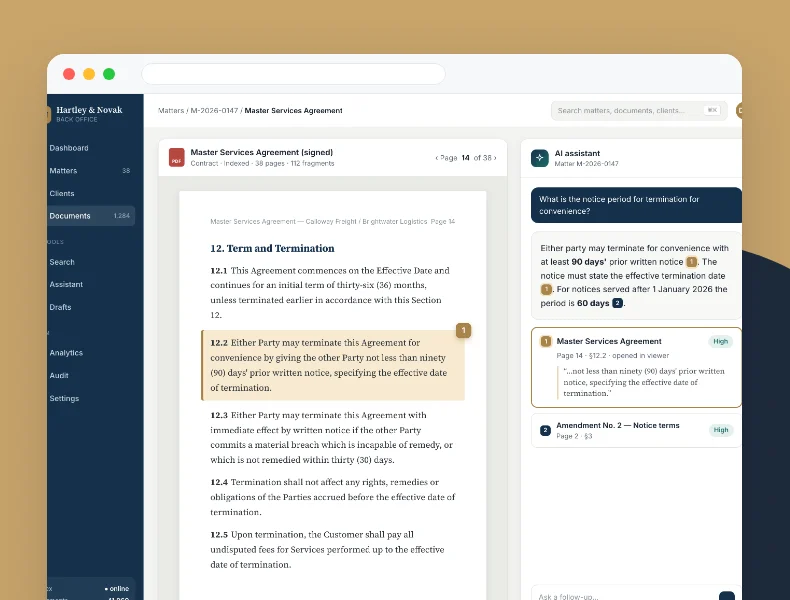
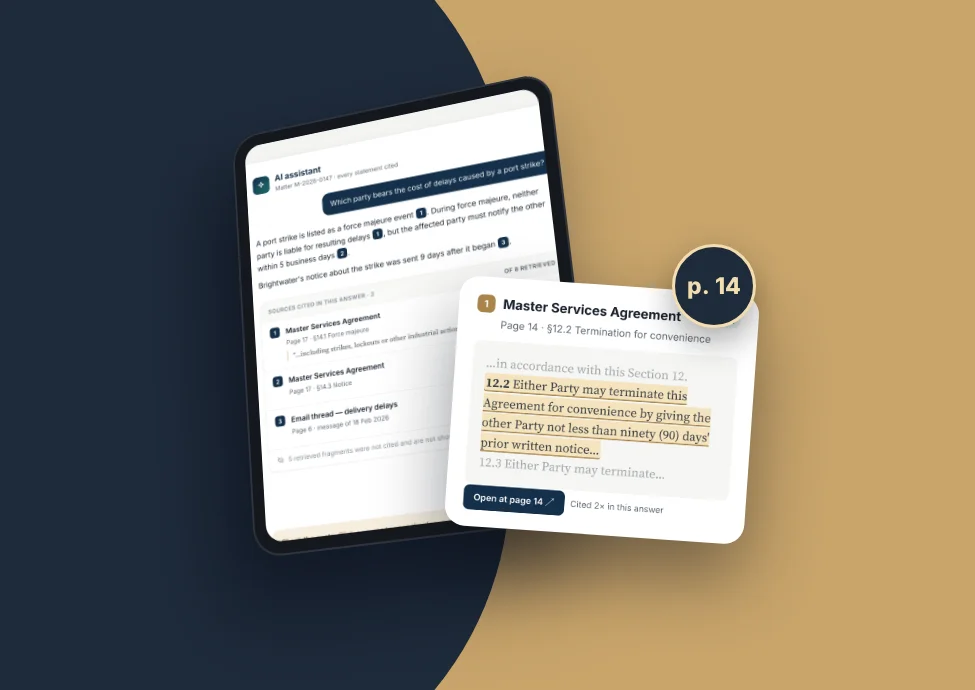
Legal-RAG-Assistent antwortet ausschließlich aus Aktendokumenten und zeigt zu jeder Aussage die Seite.
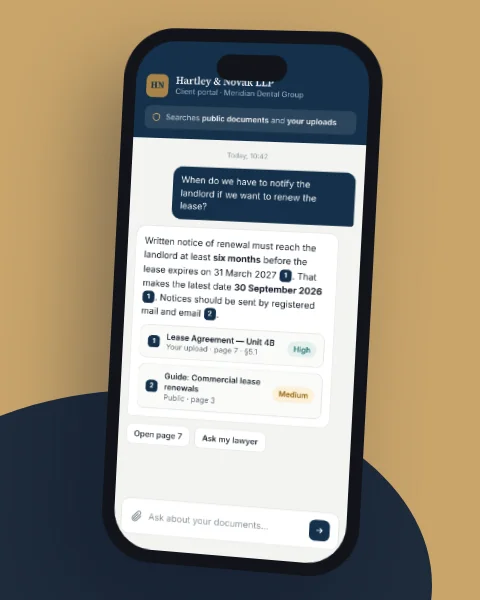
Profil des Partners
Hintergrund
Kanzleien, Rechtsabteilungen und Notariate müssen Fakten in ihren Akten finden, und jede Antwort muss der Primärquelle standhalten: Ein erfundenes Datum oder ein falscher Betrag ist inakzeptabel. Viele dürfen Mandantendokumente zudem nicht in externe Clouds übertragen. SDH hat diesen internen R&D-Prototyp entwickelt, um zu klären, wie sich ein juristischer KI-Assistent verhalten muss, wenn Korrektheit und Datenhoheit an erster Stelle stehen. Dahinter steht kein Kunde, sondern unsere eigene technische Referenz.
Ziel
Ein funktionsfähiges Backoffice für die Aktenverwaltung mit KI-Assistent, der nur aus den Dokumenten der Kanzlei antwortet und zu jeder Aussage die Herkunft zeigt. Dasselbe Retrieval sollte einen Mandanten-Chat antreiben, der nur sieht, was Mandanten sehen dürfen. Die Architektur musste Cloud- und lokale Modelle unterstützen, damit die Kanzlei über den Verarbeitungsort entscheidet, und klar sagen, wenn die Dokumente keine Antwort enthalten.
Lösung
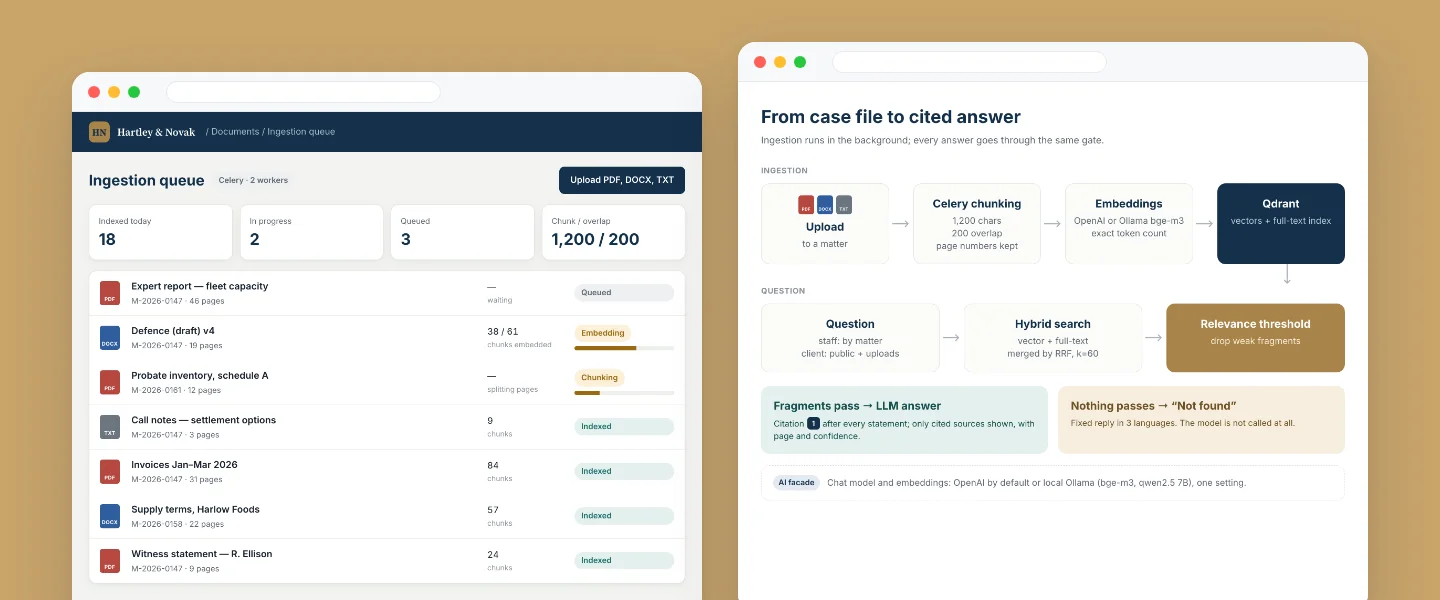
Als R&D-Projekt unserer KI-Softwareentwicklung haben wir ein juristisches Backoffice für Mandanten, Akten, Dokumente, Entwürfe, Suche, Analytics und Audit entwickelt, ergänzt um einen KI-Assistenten. Dokumente im Format PDF, DOCX und TXT werden in einer Celery-Queue verarbeitet: in überlappende Fragmente von 1.200 Zeichen mit 200 Zeichen Überlappung zerlegt, mit Seitenzahlen versehen und in Qdrant indexiert. Mitarbeitende nutzen eine Suchseite und einen Assistenten mit Filter nach Akte. Mandanten erhalten einen öffentlichen Chat, der nur als öffentlich markierte Dokumente und ihre eigenen Uploads durchsucht. Vertragsanalyse, Versionsvergleich, Entwurfserstellung, Zeitstrahl und gestreamte Antworten runden das ab. Wie bei jeder individuellen RAG-Anwendung liegt der Wert im Retrieval und in der Nachprüfbarkeit, nicht im Modell.
Die Suche ist hybrid: Vektor- und Volltextzweig werden per Reciprocal Rank Fusion (k=60) zusammengeführt. Da Qdrant Volltexttreffer ohne Ranking liefert, bewerten wir sie zuerst danach, wie viele Suchbegriffe sie abdecken. Gefiltert wird nach Akte, Dokumenttyp, Status und Datum der Erfassung.
Nachprüfbarkeit ist fest im Antwortablauf verankert:
- Fragmente unterhalb einer Relevanzschwelle werden verworfen;
- besteht keines die Schwelle, lautet die Antwort „In den Dokumenten nicht gefunden“, ohne dass das Modell aufgerufen wird;
- das Modell muss nach jeder Aussage eine Quellenangabe [n] setzen;
- angezeigt werden nur tatsächlich zitierte Quellen, mit Dokument, Seite und Konfidenzstufe.
Eine gemeinsame Fassade bedient LLMs und Embeddings: OpenAI oder lokale Ollama-Modelle (bge-m3-Embeddings, qwen2.5 7B), umschaltbar über eine einzige Einstellung. Standardmäßig ist OpenAI konfiguriert; die Architektur kann mit lokalen Modellen vollständig On-Premise laufen. Ein Wechsel des Embedding-Anbieters ändert die Vektordimensionen, daher wird die Collection neu angelegt und komplett neu indexiert. Bei kyrillischen Texten unterschätzte eine zeichenbasierte Token-Schätzung den Bedarf fast um die Hälfte und sprengte das Limit für Embedding-Anfragen; exakte Zählung mit tiktoken löste das Problem. Eine ehrliche Einschränkung: Ob ein zitiertes Fragment die Aussage tatsächlich stützt, wird nicht automatisch geprüft. Dafür gibt es die Zitat-Ansicht, in der die Juristin oder der Jurist nachprüft.
Technologien
Backend
Python 3.11, Django, Celery, uWSGI
Daten & Suche
PostgreSQL 14, Redis 7, Qdrant
KI / ML
OpenAI API, Ollama (bge-m3, qwen2.5), tiktoken
Projekte
RAG-Assistent für Kanzleien mit seitengenauen Quellenangaben
Ein SDH-Prototyp: juristisches Backoffice mit KI-Assistent, der nur aus Aktendokumenten antwortet und die Seite nennt.
Benötigen Sie einen Projektkostenvoranschlag?
Schreiben Sie uns, und wir bieten Ihnen eine qualifizierte Beratung.